Модуль 2 · как работает prometheus · сбор метрик
Глава 2.4
Scrape: как Prometheus
собирает значения
Target задаёт адрес, страница /metrics содержит числа. Scrape — действие, которое их соединяет: Prometheus запрашивает страницу и сохраняет числа. В этой главе один scrape разобран по шагам. Затем разобраны две настройки: как часто опрашивать и сколько ждать ответа. В конце показано, как выглядят ошибки опроса и что остаётся в базе, когда приложение остановлено.
- Категория
- Механизм сбора
- Уровень
- Средний
- Опирается на
- Главы 2.2 и 2.3
- Результат
- Поиск причины ошибки target по ряду up и тексту ошибки
§1Понятие scrape
В двух предыдущих главах разобраны адрес и страница: target сообщает, куда обращаться, а /metrics содержит числа. Сами по себе они ничего не сохраняют. Нужно действие, которое их соединяет: сервер обращается по адресу, получает страницу и записывает числа в базу. Это действие называется scrape.
Он похож на один заход медсестры в палату. Она заходит, измеряет температуру и записывает её в лист, а через час заходит снова. Prometheus так же отправляет запрос приложению, получает числа и записывает их, а через 15 секунд повторяет.
Scrapeсбор · один опрос одного target
Один запрос Prometheus к target вместе с обработкой ответа: Prometheus читает текст, добавляет метки target и записывает числа в базу.
Слово scrape в английском означает «соскоблить, собрать с поверхности». В русских текстах пишут «скрейп», «сбор» или «опрос». В интерфейсе и документации Prometheus используется английское слово, поэтому здесь оно сохранено.
У scrape две настройки, и обе уже встречались в файле prometheus.yml. Параметр scrape_interval задаёт, как часто повторять опрос, а scrape_timeout — сколько ждать ответа. Прежде чем разбирать их, нужно увидеть, из каких шагов состоит один опрос.
Следующий раздел проходит один scrape от начала до конца.
§2Один scrape по шагам
Схема показывает один scrape target api:8000 на стенде. Три вертикальные линии — участники: Prometheus, приложение и база TSDB. Стрелки — сообщения между ними, оранжевые стрелки несут данные. Кнопка «шаг →» открывает шаги по одному.
В этой последовательности есть две подробности, которые понадобятся дальше. Первая: время ставится один раз, в начале запроса, и одинаково для всех чисел одного scrape. Вторая: ряд up записывается в самом конце, потому что его значение зависит от того, удались ли все предыдущие шаги.
Из схемы видно ещё одно свойство. Scrape — обычный HTTP-запрос, и приложение обрабатывает его так же, как запрос пользователя. Поэтому запросы к /metrics попадают в лог приложения: за время работы стенда сервер uvicorn записал 363 строки "GET /metrics HTTP/1.1" 200 OK. По той же причине счётчик запросов мог бы расти от самих опросов, и приложение стенда запросы к /metrics в нём не учитывает.
Первый шаг схемы — «прошло 15 секунд». Откуда берётся это число и на что оно влияет, разбирает следующий раздел.
§3Scrape interval
scrape_interval — это время между началами двух соседних scrape одного target. На стенде оно равно 15 секундам, и обычно выбирают 15 или 30 секунд. От интервала зависит, как часто Prometheus получает значения и какие изменения между опросами он пропустит.
Камера делает один снимок раз в минуту. Машина заехала и уехала за 20 секунд между снимками. На снимках её нет.
Prometheus получает числа раз в интервал. Число выросло и вернулось между двумя опросами. В сохранённых данных этого роста нет.
От интервала зависят три вещи. Первая — подробность истории: за минуту при интервале 15 секунд сохраняется четыре числа на ряд, при 60 секундах одно. Вторая — объём данных: для 10 000 рядов это 40 000 чисел в минуту против 10 000. Третья — скорость обнаружения: остановку приложения Prometheus заметит только при следующем scrape, то есть при интервале 60 секунд в худшем случае через минуту. Короткий интервал даёт подробную историю и быструю реакцию, но увеличивает объём.
Что теряется между опросами
Сравнение с камерой подсказывает, что между опросами данные теряются. Но теряются они по-разному для двух типов метрик. Gauge показывает значение в момент опроса, и всё, что было между опросами, пропадает. Counter накапливает события в памяти приложения, поэтому следующий опрос получит их сумму. Пример ниже показывает оба случая на одном отрезке времени; числа в нём условные.
С 32-й по 39-ю секунду пришло 60 запросов. Очередь выросла до 40 задач и вернулась к 3, а опроса в это время не было. Значение очереди 40 в данные не попало: на 30-й и на 45-й секунде очередь равнялась 3. Счётчик же на 45-й секунде показал 160, и прирост в 60 запросов сохранён, хотя момент всплеска неизвестен.
Из этого следует практическое правило. События считают счётчиками, потому что счётчик их не теряет. Gauge используют для величин, которые меняются медленнее интервала: память, число открытых соединений, длина очереди под постоянной нагрузкой.
Распределение опросов по интервалу
Осталось уточнить, в какой момент внутри интервала происходит scrape. Если бы все target опрашивались в одну секунду, тысяча программ получала бы запрос одновременно, а сервер каждые 15 секунд обрабатывал бы тысячу ответов сразу. Поэтому Prometheus назначает каждому target своё место внутри интервала. На стенде шесть заданий и интервал 15 секунд; на схеме слева начало интервала, справа его 15-я секунда.
Точки не совпадают: запросы распределены по времени. Место каждого target постоянно, в четырёх опросах подряд оно менялось не больше чем на 7 миллисекунд. Prometheus вычисляет его по адресу и меткам target.
Подробнее: интервал по умолчанию и где его задают
Интервал задают в разделе global для всех заданий. В отдельном задании его можно изменить. Если интервал не задан совсем, Prometheus использует 1 минуту. Это видно в загруженной конфигурации (Status → Configuration) для файла, где записаны только задание и target:
global:
  scrape_interval: 1m
  scrape_timeout: 10s
  evaluation_interval: 1m
scrape_configs:
- job_name: api
  scrape_interval: 1m
  scrape_timeout: 10s
  metrics_path: /metrics
  scheme: http
Распределение опросов по интервалу использовалось ещё в системе Borgmon компании Google. Оно описано в главе 10 книги Google «Site Reliability Engineering».
Интервал задаёт начало scrape. Вторая настройка задаёт его предельную длительность.
§4Scrape timeout
Отправив запрос, Prometheus ждёт ответа, и ждать бесконечно он не может: следующий scrape начнётся по расписанию. Поэтому у ожидания есть предел. Так же поступает человек, который звонит по телефону: он ждёт десять гудков, а если трубку не взяли, заканчивает вызов и перезванивает позже.
scrape_timeout — время, которое Prometheus ждёт ответа. Оно считается от начала запроса до получения всего текста и по умолчанию равно 10 секундам. Если ответ за это время не пришёл, Prometheus обрывает запрос, и scrape считается неуспешным.
На стенде это проверено опытом. Адрес /metrics/slow отвечает через 3 секунды, а в задании slow timeout равен 2 секундам. Для сравнения на схеме показано и рабочее задание api. Вся дорожка — интервал 15 секунд, пунктир — время ожидания.
У задания api ответ приходит за 6 миллисекунд при пределе 10 секунд. У задания slow ответ готов через 3 секунды, а ожидание заканчивается через 2. В интерфейсе это выглядит так:
Error scraping target: Get "http://api:8000/metrics/slow": context deadline exceeded
scrape_duration_seconds{job="slow"}  2.001425834
Текст context deadline exceeded означает «время ожидания истекло». Prometheus оборвал запрос через 2,001 секунды. Приложение при этом продолжает готовить ответ, потому что запрос обрывается на стороне Prometheus. Когда /metrics отвечает медленно, сначала ищут причину в приложении: частые причины — запрос к базе данных при каждом опросе или большое число рядов. Если только увеличить timeout, причина останется.
Два правила для timeout
Timeout и interval связаны: ожидание должно закончиться до начала следующего scrape. Из этого вытекают два правила, оба проверены на стенде.
- Timeout не больше interval. Иначе Prometheus не загружает конфигурацию. Проверка файла с
scrape_interval: 15sиscrape_timeout: 20s:FAILED: parsing YAML file …: scrape timeout greater than scrape interval for scrape config with job name "api" - Если timeout не задан, а interval меньше 10 секунд, timeout равен interval. Для
scrape_interval: 5sбез timeout Prometheus загрузилscrape_timeout: 5s.
Значение timeout Prometheus сообщает приложению в заголовке запроса X-Prometheus-Scrape-Timeout-Seconds.
Обе настройки разобраны по отдельности. В следующем разделе их можно менять вместе и смотреть на результат.
§5Модель сбора
Модель показывает три минуты работы одного target по правилам из §3 и §4. Пунктирная линия — настоящая длина очереди в приложении; на 62-й секунде очередь на 7 секунд вырастает. Оранжевая линия — значения, которые сохранит Prometheus. Зелёная линия — ряд up. Интервал, timeout и время ответа меняются ползунками, а флажок останавливает приложение на 35 секунд.
С моделью можно проделать четыре опыта, и каждый повторяет один из выводов главы. Сначала переключите интервал с 15 на 30 и 60 секунд: при 15 секундах рост очереди на 62-й секунде попадает в данные, при 30 и 60 его нет. Затем сделайте время ответа больше timeout: каждый scrape станет неуспешным, ряд up опустится до 0, а оранжевая линия исчезнет. Потом сделайте timeout больше интервала: появится сообщение, что конфигурация не загружается. Наконец, включите флажок остановки: оранжевая линия прервётся и продолжится после первого успешного scrape.
В опытах scrape был то успешным, то неуспешным. Следующий раздел точно определяет, какой scrape считается успешным.
§6Успешный scrape и ряды о сборе
Scrape состоит из нескольких шагов, и неудача на любом из них делает неуспешным весь scrape. Так устроена и доставка посылки: курьер должен найти дом, ему должны открыть дверь, получатель должен расписаться. Если не выполнен любой шаг, посылка не вручена. У scrape таких шагов шесть, и они проверяются по порядку.
Четвёртая и пятая проверки знакомы по главе 2.3: это заголовок Content-Type и правила записи строк. Шестая проверка относится к лимитам задания, которые ограничивают число рядов, число меток и размер ответа; по умолчанию они выключены. Если хотя бы одна проверка не пройдена, из ответа не сохраняется ни одно число.
Ряды, которые Prometheus записывает сам
Результат проверок нужно где-то хранить, иначе неуспешный scrape нигде не отразится. Поэтому после каждого scrape, успешного и неуспешного, Prometheus записывает пять рядов о самом опросе. В ответе приложения этих рядов нет. В таблице — значения последнего scrape target api:8000 на стенде.
| Ряд | Значение | Что означает |
|---|---|---|
up | 1 | 1 — scrape успешный, 0 — неуспешный. По этому ряду проверяют, доступен ли target |
scrape_duration_seconds | 0.006035834 | Сколько длился scrape: 6 миллисекунд |
scrape_samples_scraped | 3 | Сколько чисел было в ответе |
scrape_samples_post_metric_relabeling | 3 | Сколько чисел осталось после правил отбора. На стенде правил нет |
scrape_series_added | 0 | Сколько новых рядов появилось. Все три ряда уже были, поэтому 0 |
По этим рядам проблемы заметны раньше, чем по метрикам приложения. Если up равен 0, target недоступен, и причина записана в тексте ошибки на странице Target health. Если scrape_duration_seconds приближается к timeout, ответ замедляется, и скоро scrape начнут обрываться по времени. Если scrape_samples_scraped растёт без изменений в коде, рядов становится больше: в какую-то метку попадает много разных значений, о чём предупреждала глава 2.1.
Подробнее: откуда взялись эти ряды
В описании системы Borgmon в книге Google SRE сказано, что Borgmon записывает для каждого target дополнительные переменные: найден ли адрес, ответил ли target, когда опрос закончился. По ним составляют правила, которые находят недоступные программы. Ряды up и scrape_* в Prometheus решают ту же задачу.
С флагом запуска --enable-feature=extra-scrape-metrics добавляются ещё три ряда: настроенный timeout, настроенный sample_limit и размер ответа в байтах.
Ряд up сообщает только, что scrape не удался. Причину сообщает текст ошибки, и следующий раздел показывает, как его читать.
§7Неуспешный scrape: шесть ошибок
Чтобы получить настоящие тексты ошибок, стенд запускается с файлом prometheus-errors.yml. В нём рабочее задание api и пять заданий, в каждом из которых допущена одна ошибка. Все задания обращаются к одному приложению.
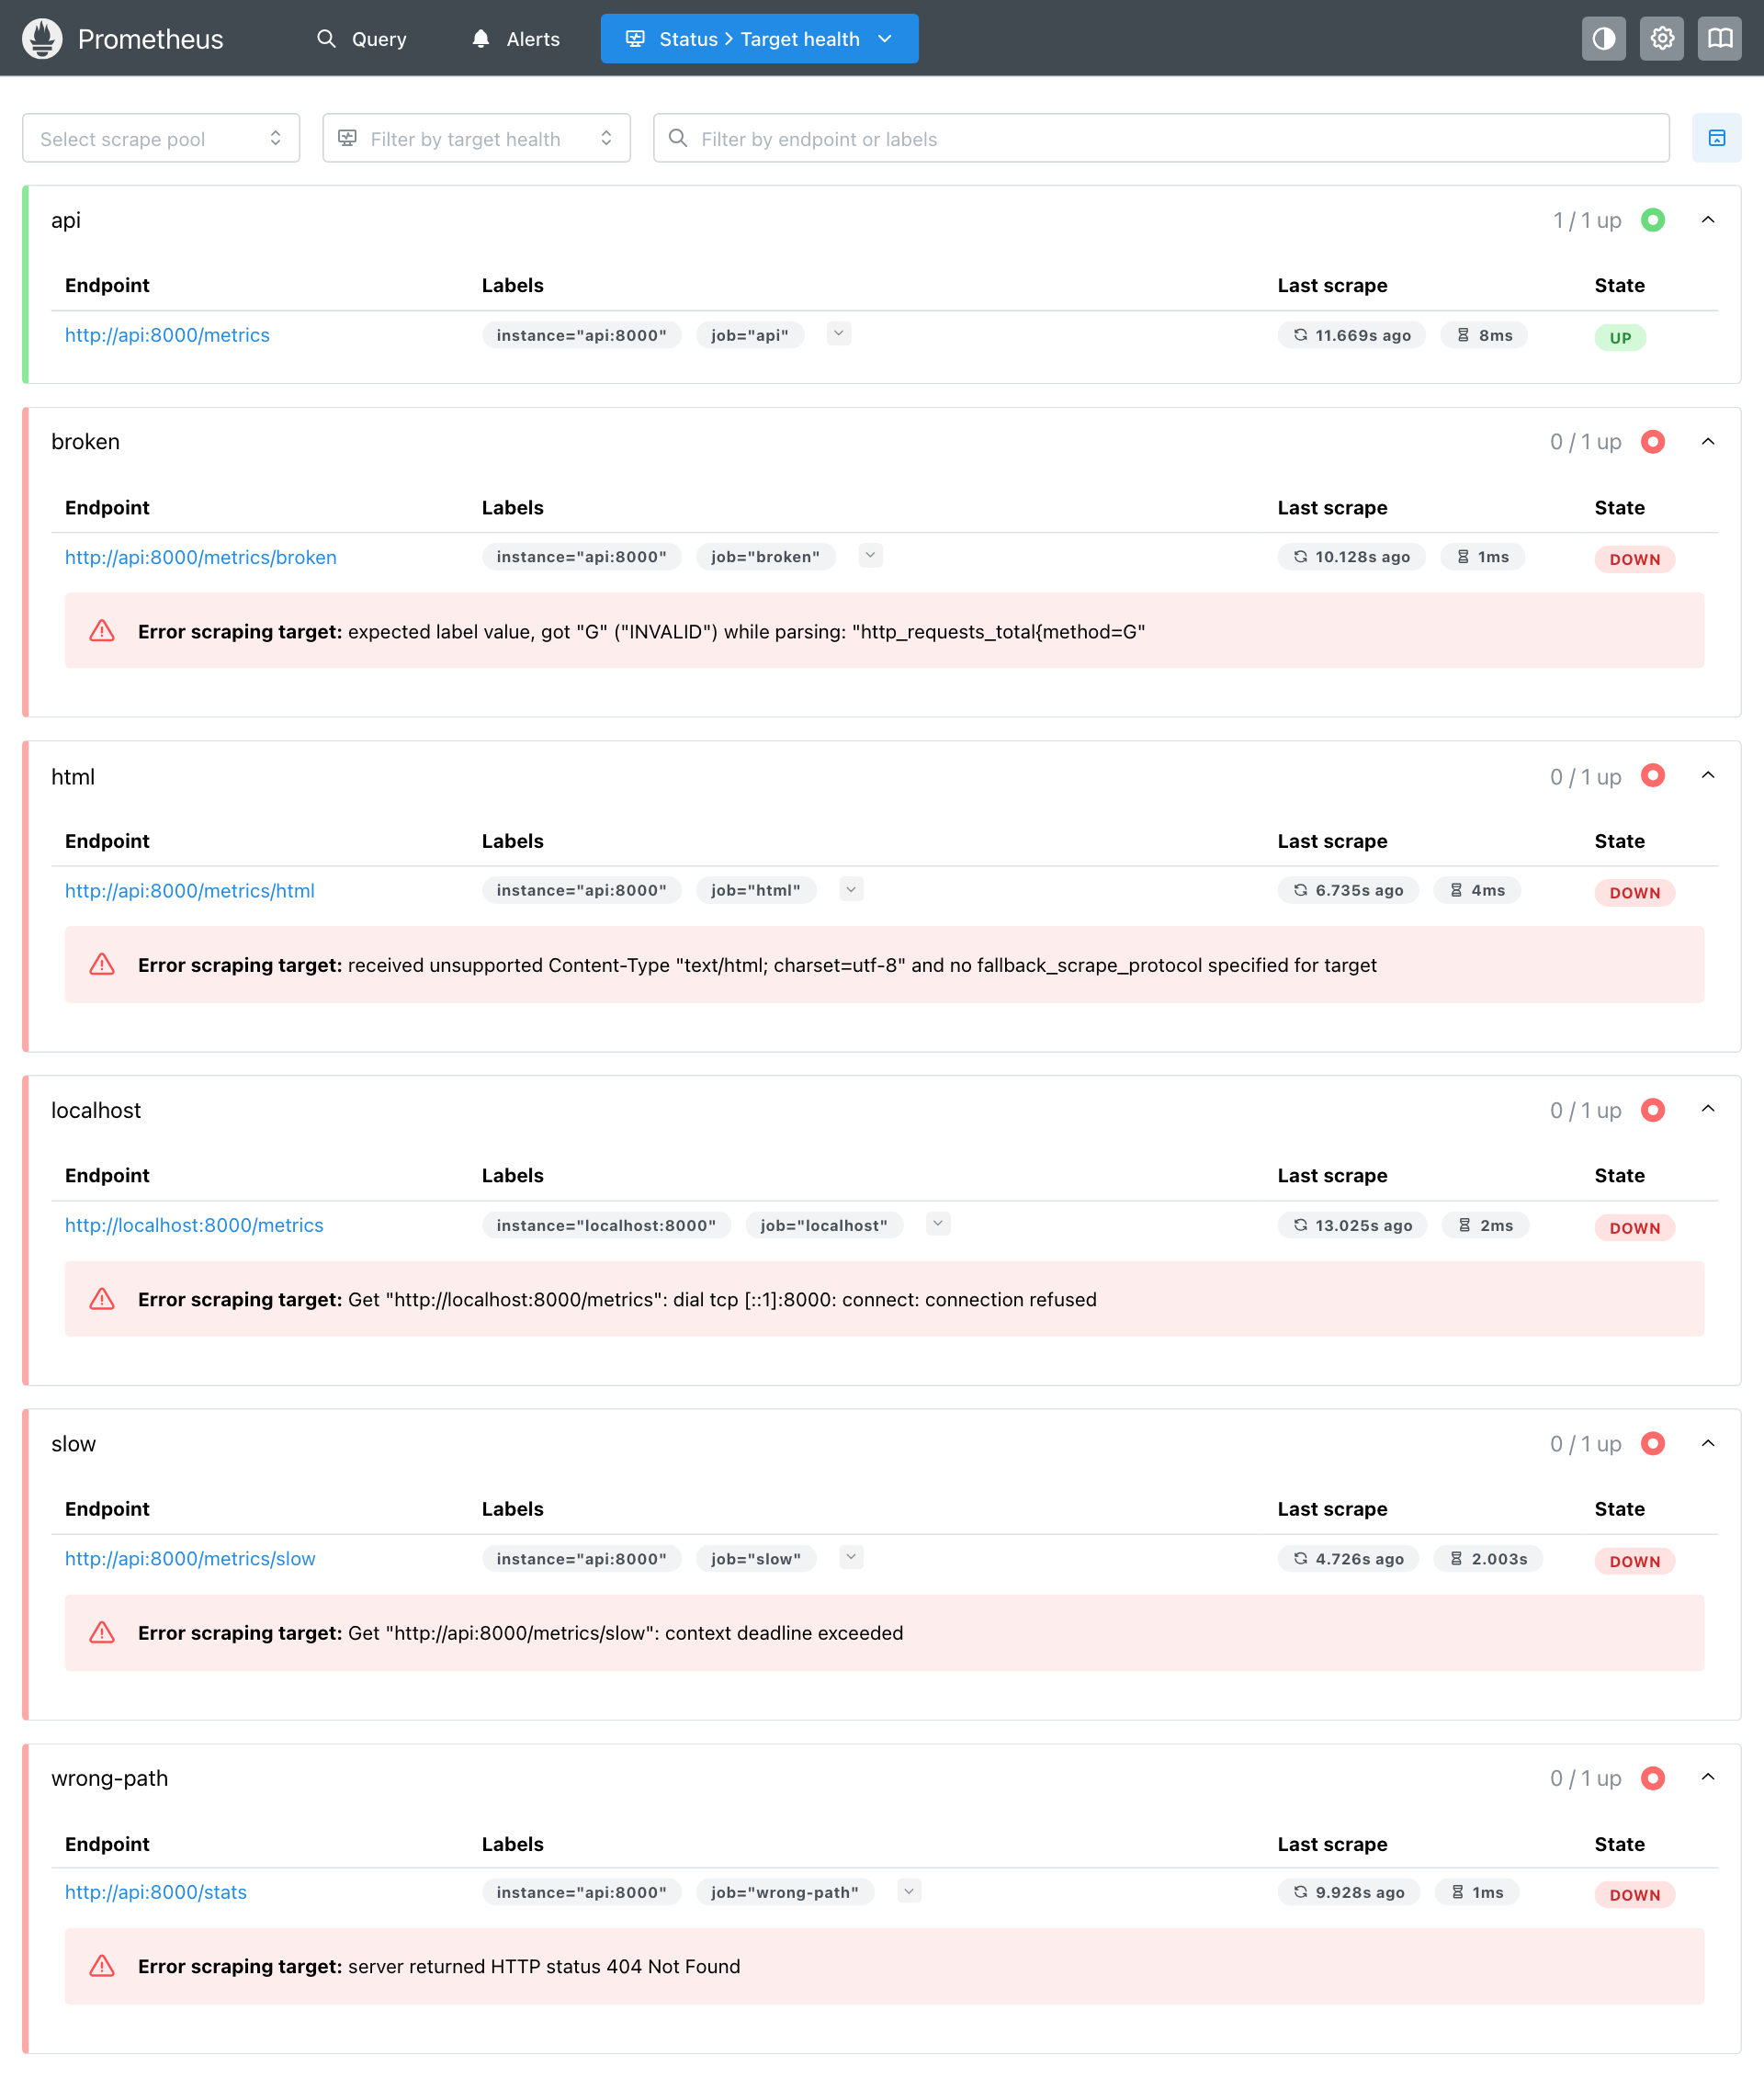
Тексты ошибок длинные, но читать их целиком не нужно. Начало текста показывает, на какой из шести проверок scrape остановился. Слова dial tcp и connection refused означают, что не установлено соединение. Слова context deadline exceeded — что истекло время ожидания. HTTP status 404 означает, что приложение ответило, но по этому пути метрик нет. unsupported Content-Type — что ответ получен, а заголовок неправильный. Слова while parsing — что в строке текста ошибка записи.
В таблице шесть ошибок стенда: пять из заданий с ошибкой и одна, которая появляется при остановке приложения. Для каждой указано, что проверить.
| Задание | Текст ошибки | Причина | Что проверить |
|---|---|---|---|
slow | Get "http://api:8000/metrics/slow": context deadline exceeded | Ответ дольше timeout | Время ответа: curl -w '%{time_total}'. Что делает код обработчика |
wrong-path | server returned HTTP status 404 Not Found | Неверный metrics_path | Открыть путь в браузере |
localhost | Get "http://localhost:8000/metrics": dial tcp [::1]:8000: connect: connection refused | По адресу никто не отвечает | Откуда смотрит Prometheus (глава 2.2, §4). Запущено ли приложение |
broken | expected label value, got "G" ("INVALID") while parsing: "http_requests_total{method=G" | Ошибка записи в тексте | Строку, на которой остановилось чтение |
html | received unsupported Content-Type "text/html; charset=utf-8" and no fallback_scrape_protocol specified for target | Неверный заголовок | Заголовки ответа: curl -i |
api, приложение остановлено | Get "http://api:8000/metrics": EOF, затем context deadline exceeded | Контейнер приложения остановлен | docker compose ps, лог приложения |
Текст последней ошибки зависит от окружения. В Docker Desktop после остановки контейнера сначала была ошибка EOF, затем context deadline exceeded.
У этого опыта есть побочный результат, и он показывает, что ошибка в настройке опроса меняет метрики приложения. Задание wrong-path каждые 15 секунд запрашивает путь /stats. Такого пути нет, приложение отвечает кодом 404 и считает этот ответ в своём счётчике http_requests_total{status="404"}. За несколько минут опыта значение выросло до 59, хотя пользователи ошибочных запросов не отправляли.
Известно, как выглядит неуспешный scrape в интерфейсе. Следующий раздел показывает, что после него остаётся в базе.
§8Что остаётся в базе
Последний опыт главы проведён на рабочей конфигурации стенда и состоит из трёх действий. В 13:22:41 приложение остановлено командой docker compose stop api. В 13:23:32 оно запущено снова. После запуска на него отправлено 90 запросов тремя порциями по 30. Всё это время Prometheus продолжал работать, и на схеме показано, что он записал в два ряда.
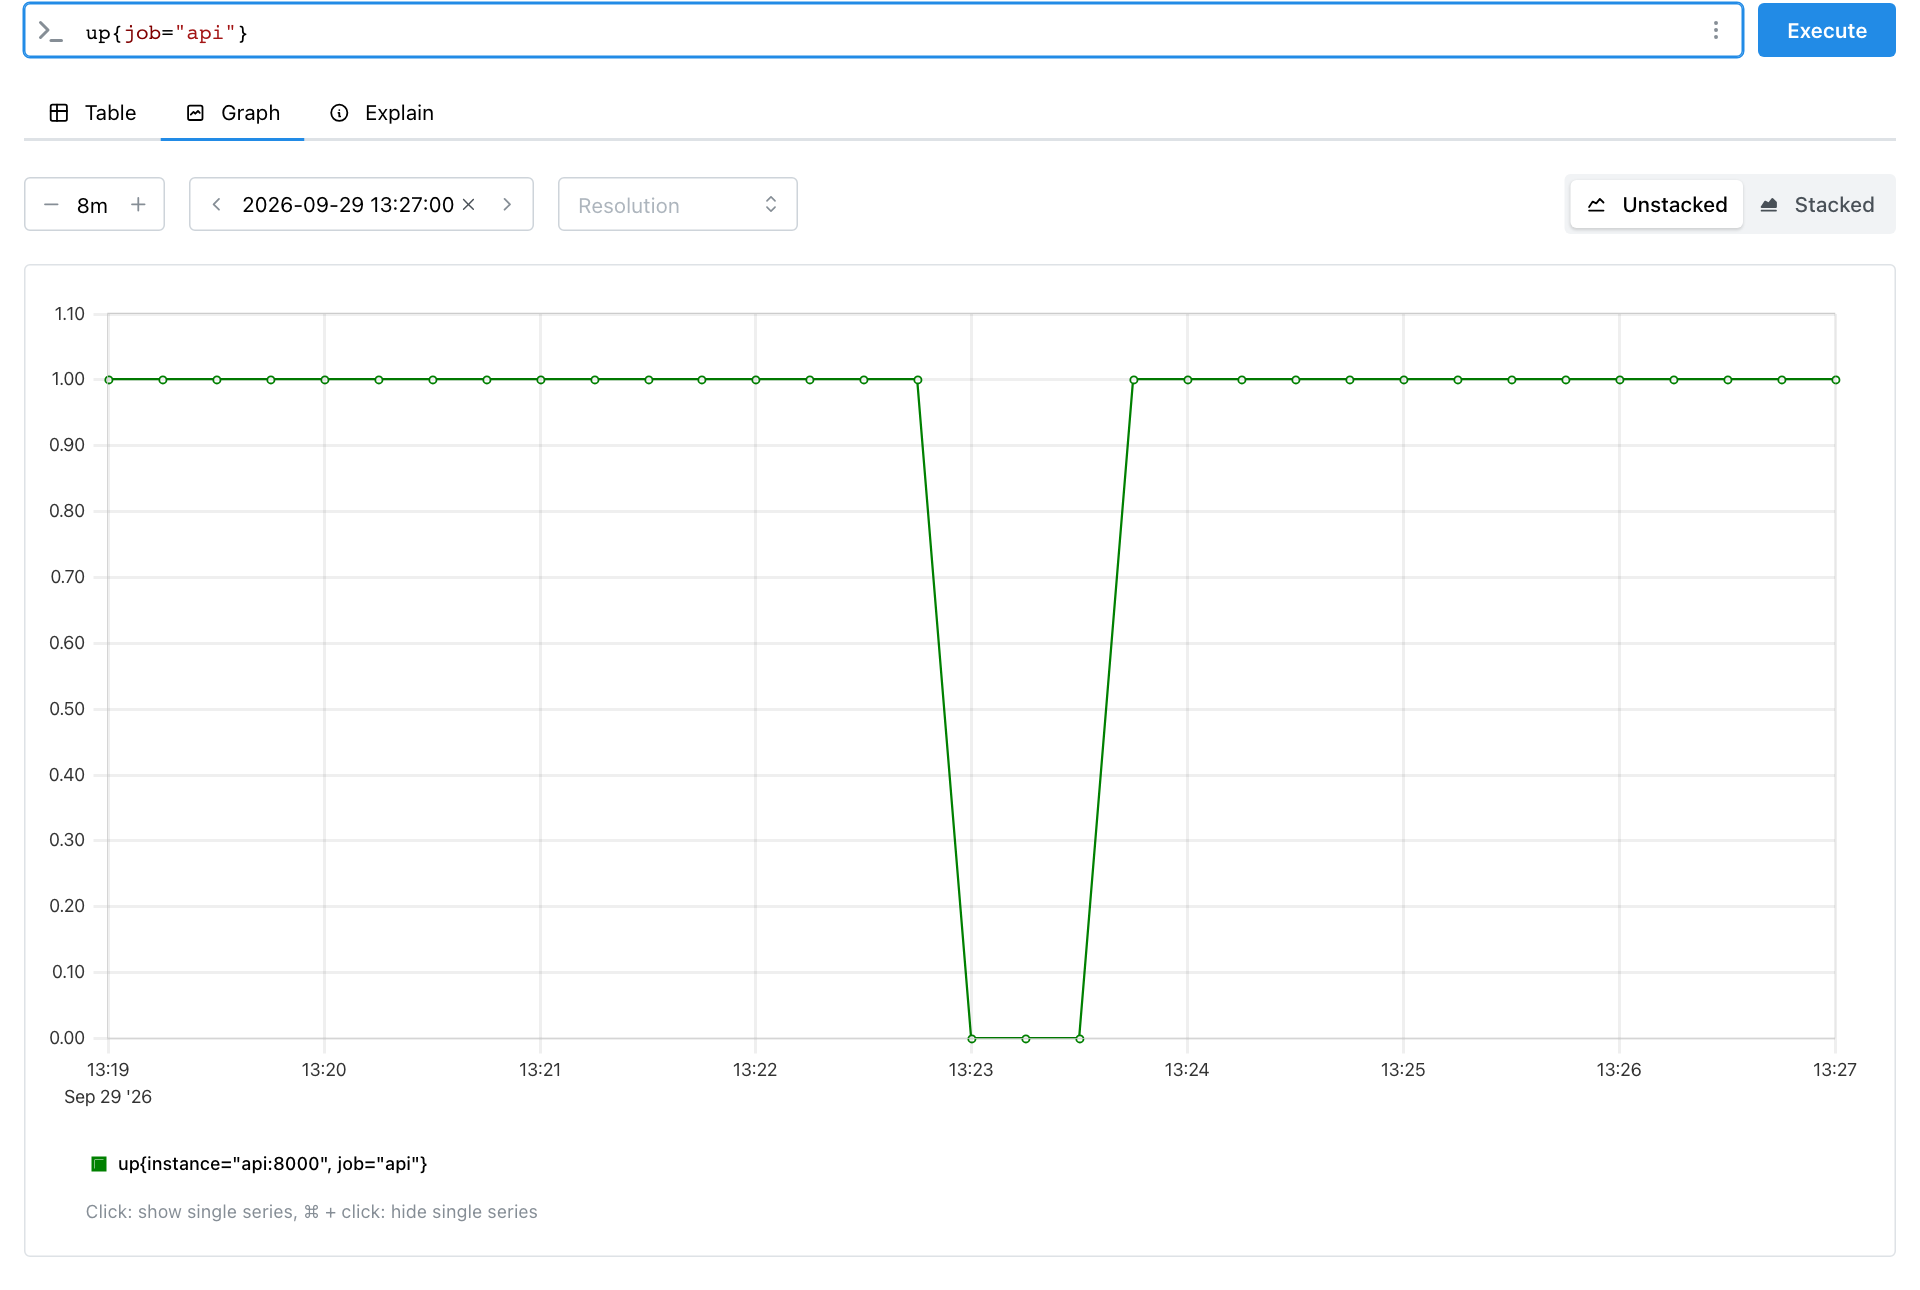
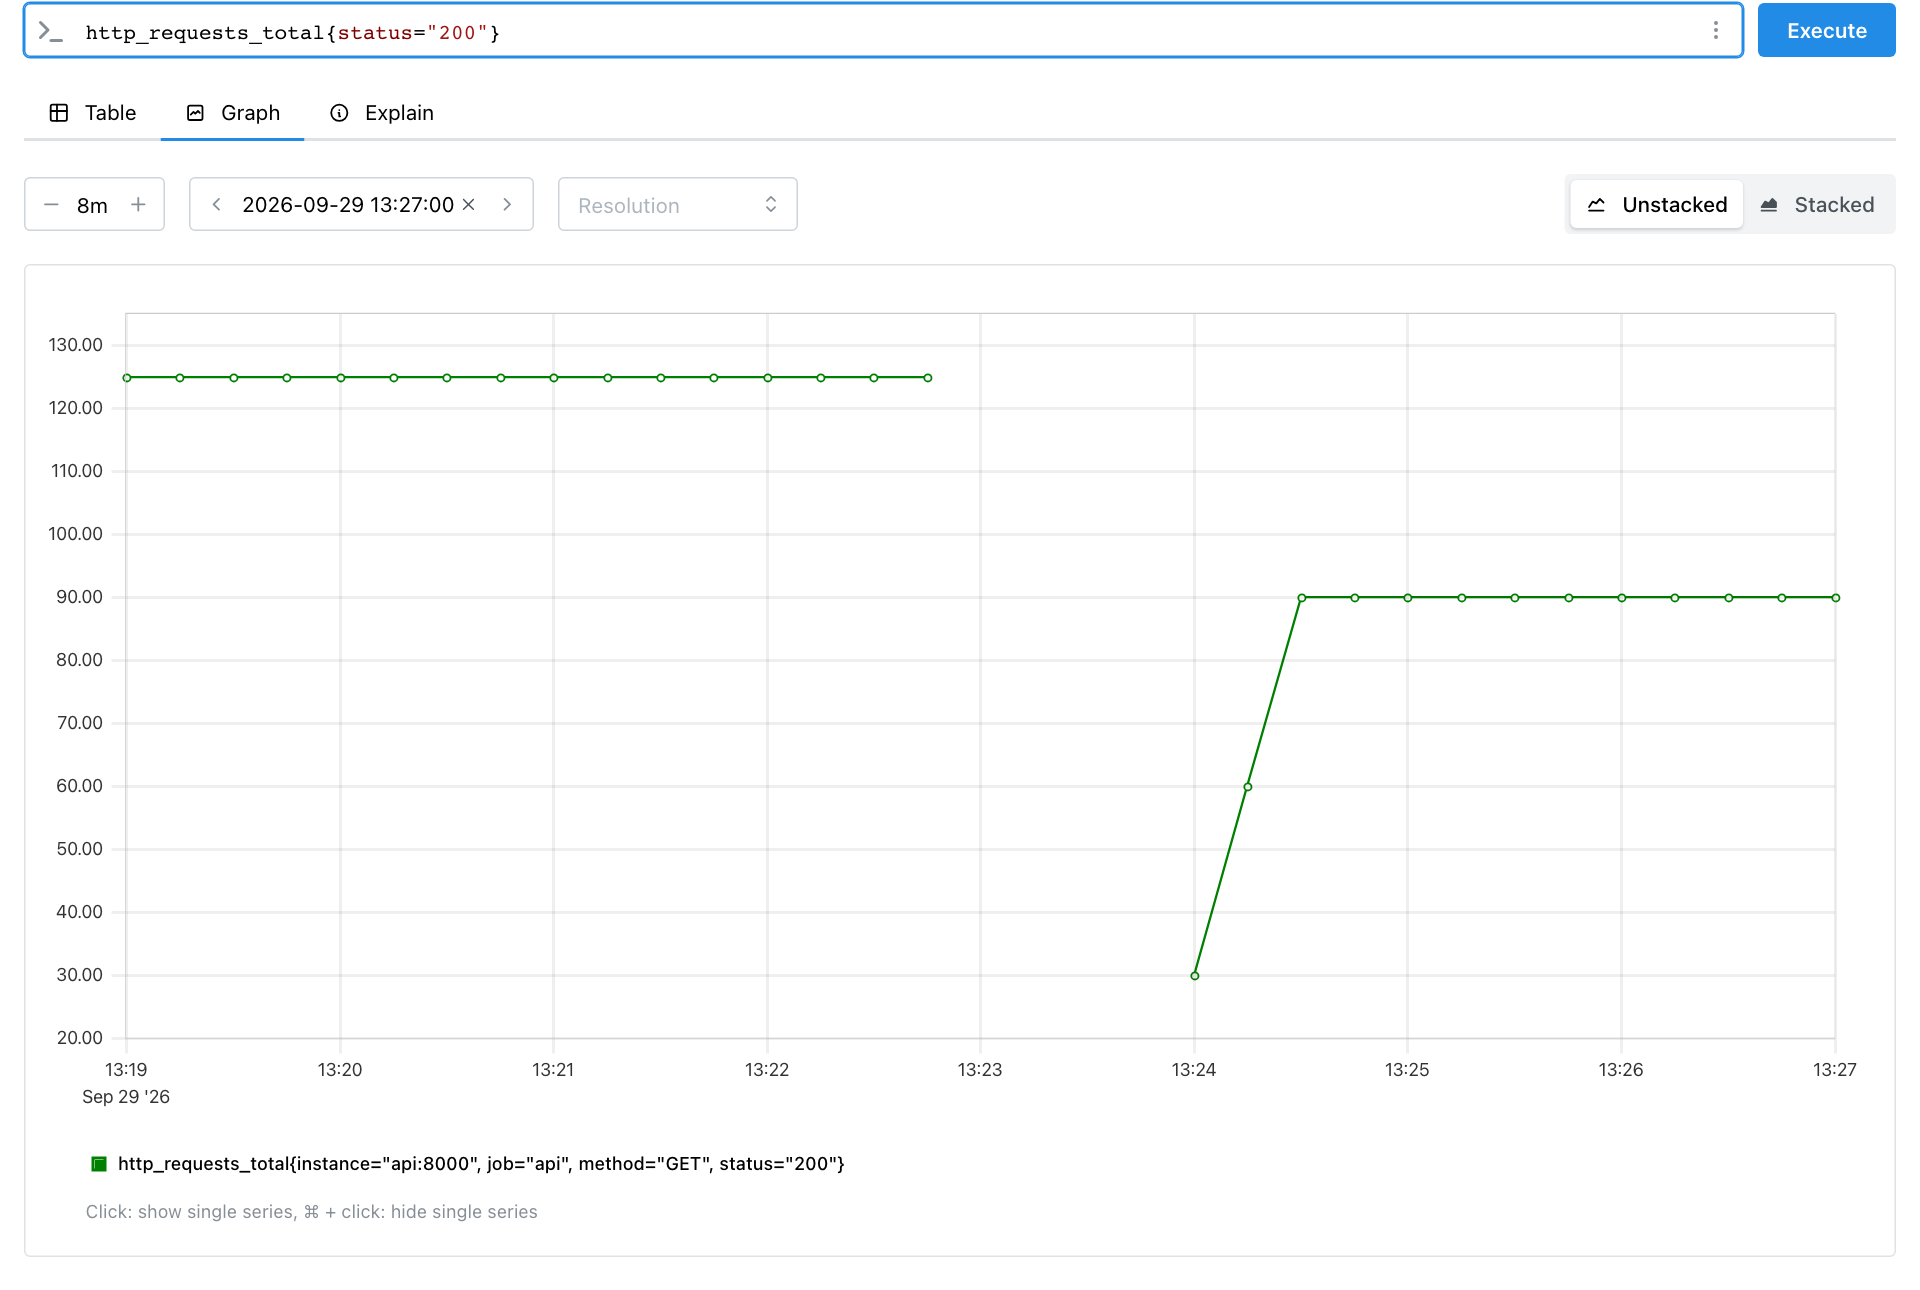
Верхняя строка значений — ряд up, нижняя — ряд http_requests_total{status="200"}. Прочерк означает, что числа в это время нет. Те же два ряда можно посмотреть на графиках из интерфейса Prometheus.
Те же ряды на графикепереключите вкладку
В этих данных четыре наблюдения, и идут они в порядке времени.
- Ряд
upзаписан и во время остановки. Prometheus пишет его после каждого scrape. По нему видны начало и конец остановки с точностью до одного интервала: приложение остановлено в 13:22:41, первый ноль записан в 13:22:52. - Ряд приложения прерван сразу. После неуспешного scrape в 13:22:52 Prometheus поставил на ряду
http_requests_totalотметку «устарел». Запросhttp_requests_totalво время остановки возвращал пустой результат. - После запуска ряда нет до первого запроса к приложению. В 13:23:37 ряд
upуже равен 1. Новая программа ещё не создала ряд счётчика (глава 2.3, §5). - Часть событий потеряна. Перед остановкой на приложение было отправлено ещё 20 запросов. Последний успешный scrape прошёл в 13:22:37, раньше этих запросов. В Prometheus они не попали.
Отдельного объяснения требует последний столбец. До остановки счётчик показывал 125, после запуска он показывает 30, то есть значение уменьшилось. Для counter это обычное событие: программа перезапущена, и счёт начат заново. Запросы, которые считают скорость роста, определяют уменьшение значения как перезапуск и отрицательную скорость не показывают. Потерянные 20 запросов восстановить нельзя, и по этой причине документация не советует Prometheus для точного учёта (глава 2.1, §7).
Подробнее: зачем нужна отметка «устарел»
Запрос ищет последнее число ряда в пределах пяти минут назад. Это время называется lookback delta. Без отметки «устарел» (stale marker) Prometheus показывал бы число 125 ещё пять минут после остановки приложения.
Числа, записанные до остановки, остаются в базе. Их возвращает запрос last_over_time(http_requests_total{job="api"}[5m]).
§9Проверьте себя
Вопрос 1В задании scrape_interval: 15s и scrape_timeout: 20s. Что произойдёт?
Опрос не начнётся: конфигурация не пройдёт проверку.
Верно.
promtool check configна стенде выдалscrape timeout greater than scrape interval.Timeout подстраивается под interval, только когда timeout не задан. Неверное значение, заданное явно, — ошибка.
Вопрос 2Какое время получит число http_requests_total, если scrape начался в 12:00:00.000, а ответ пришёл через 40 мс?
Верно. Все числа одного scrape получают время начала запроса.
Длительность видна в ряду
scrape_duration_seconds. Время числа — начало scrape.Библиотека не хранит время изменения и не передаёт его в ответе.
Вопрос 3Ошибка target: server returned HTTP status 404 Not Found. На каком шаге остановился scrape?
Тогда в тексте было бы
dial tcp. Код 404 означает, что приложение ответило.Верно. Проверяют
metrics_pathзадания и путь, по которому приложение отдаёт метрики.Текст ответа с кодом, отличным от 200, Prometheus не читает.
Вопрос 4Приложение остановилось в 12:00:05, последний успешный scrape был в 12:00:00, интервал 15 с. Что вернёт запрос http_requests_total в 12:00:30?
Так было бы без отметки «устарел». Неуспешный scrape в 12:00:15 поставил её на ряды приложения.
Верно, так было на стенде. Последние значения возвращает функция
last_over_time.Остановленное приложение на запросы не отвечает. Нулём становится только
up.
Вопрос 5Очередь выросла на 7 секунд. При интервале 30 с этого может не быть в данных. Число запросов за те же 7 секунд в данные попадёт. Почему?
Интервал общий для всех рядов target и от типа не зависит.
Верно. Прирост счётчика за 7 секунд будет в следующем числе. Длина очереди к моменту scrape уже вернулась к прежней.
Правила отбора работают с метками. Значения они не сравнивают.
- Prometheus. Configuration: scrape_config — prometheus.io/docs/prometheus/latest/configuration/configuration
- Prometheus. Jobs and instances: automatically generated labels and time series — prometheus.io/docs/concepts/jobs_instances
- Prometheus. Querying basics: staleness — prometheus.io/docs/prometheus/latest/querying/basics
- Beyer B. и др. Site Reliability Engineering. Глава 10. Practical Alerting from Time-Series Data — sre.google/sre-book/practical-alerting
- Стенд модуля: опыты с ошибками, остановкой приложения и конфигурацией выполнены 29.09.2026, Prometheus 3.5.0